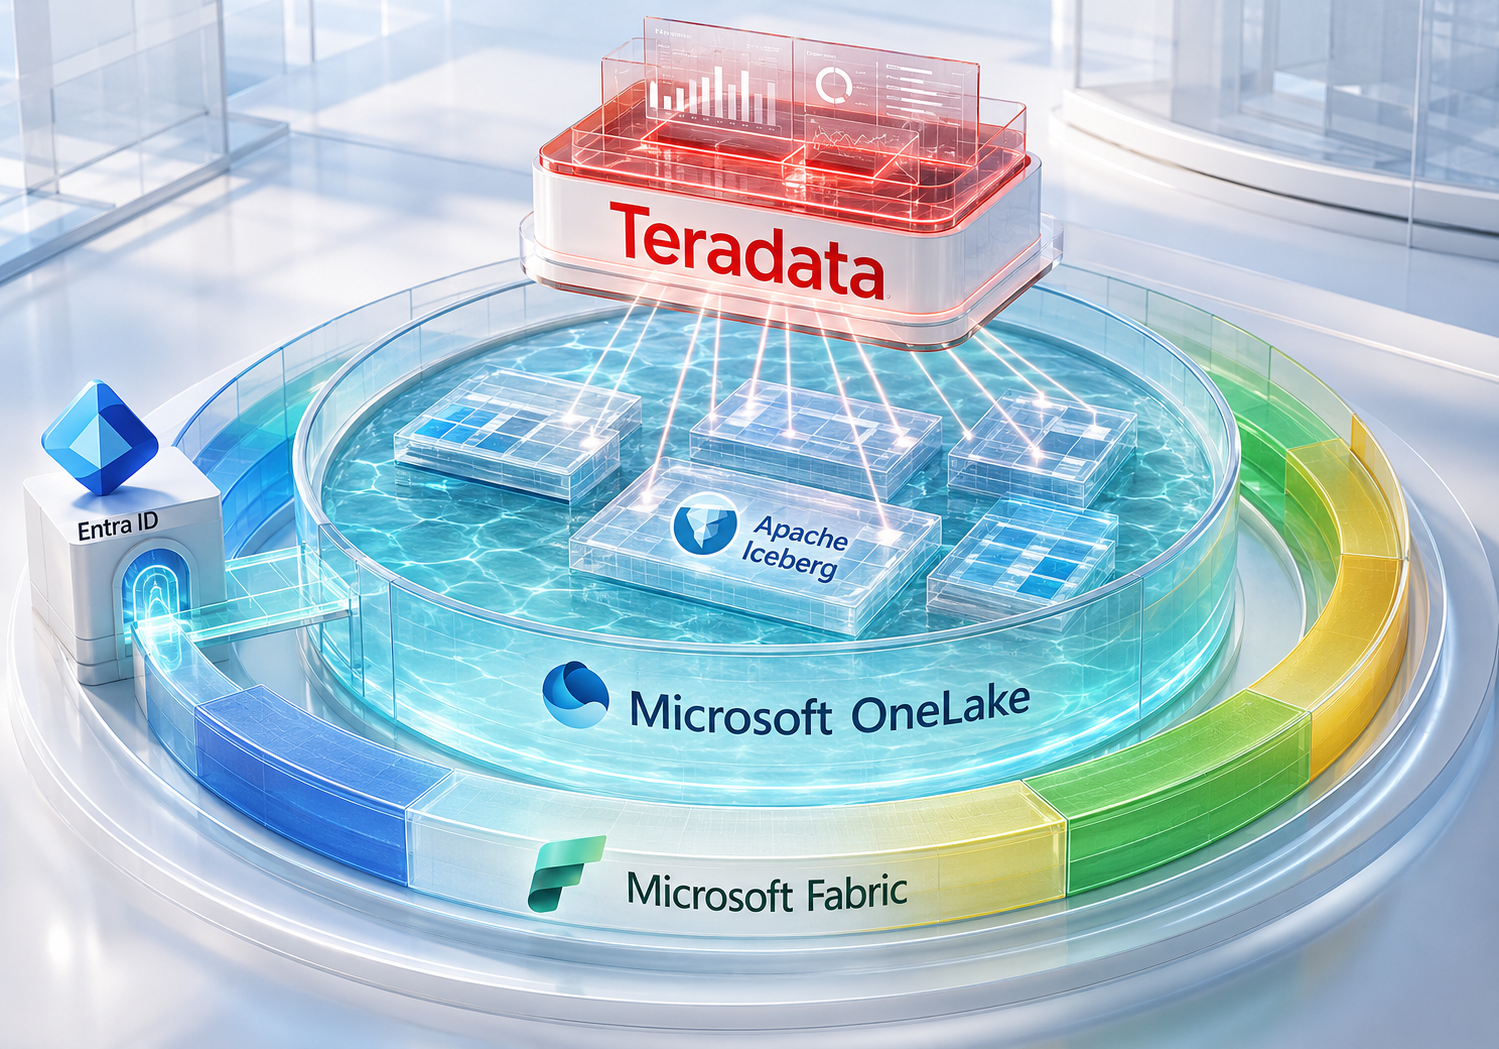
Teradata anunció el 2 de septiembre de 2026 una integración entre Teradata Autonomous Knowledge Platform y Microsoft OneLake que permite ejecutar capacidades de analítica e inteligencia artificial directamente sobre los datos almacenados en OneLake. La conexión evita procesos de ETL, duplicación y migración, tres tareas que suelen incrementar el coste, el tiempo de preparación y la complejidad de gobierno en los proyectos empresariales de datos.
La compañía sitúa la interoperabilidad en el centro del acuerdo técnico. La solución utiliza estándares abiertos de Apache Iceberg y consulta la información en su ubicación original mediante las API de Iceberg. El acceso de lectura está disponible desde el anuncio; el comunicado carece de una confirmación equivalente para operaciones de escritura. Esa delimitación resulta relevante al valorar los casos de uso y planificar arquitecturas productivas.
Para las organizaciones que trabajan con Microsoft Fabric y Teradata, la propuesta abre una vía para combinar activos de ambos entornos manteniendo OneLake como repositorio. El objetivo operativo consiste en acercar los motores analíticos y de IA a los datos, reducir movimientos innecesarios y conservar controles empresariales coherentes entre plataformas.
Analítica e IA sobre los datos en su ubicación original
OneLake funciona como el lago de datos lógico de Microsoft Fabric y proporciona una capa común para los distintos motores y experiencias de la plataforma. La integración anunciada permite que Teradata consulte esos conjuntos de datos in situ, en lugar de crear una copia previa dentro de otro entorno. Este enfoque puede acortar la preparación de proyectos, especialmente cuando una empresa reúne grandes volúmenes de información y aplica políticas estrictas sobre su localización.
Teradata señala que la conexión admite cargas exigentes, entre ellas joins complejos, pipelines de características para inteligencia artificial y consultas tácticas sujetas a acuerdos de nivel de servicio. La combinación amplía el abanico desde la exploración analítica hasta procesos operativos en los que la latencia y la previsibilidad forman parte del compromiso con el negocio. La capacidad real dependerá del diseño de cada carga, la calidad de los datos y la configuración adoptada.
Los equipos también pueden combinar información procedente de Teradata con datos alojados en OneLake. Esta posibilidad resulta útil para modelos que necesitan señales repartidas entre sistemas: historial comercial, actividad digital, operaciones, inventario o atención al cliente. El valor aparece cuando esos datos se relacionan con criterios comunes, trazabilidad suficiente y reglas claras sobre qué plataforma ejecuta cada parte del procesamiento.
Apache Iceberg y Entra ID como base de interoperabilidad
La elección de Apache Iceberg aporta una capa abierta para describir y consultar tablas a gran escala. Su presencia reduce la dependencia de conectores propietarios diseñados para una combinación concreta de productos y favorece arquitecturas en las que varios motores trabajan sobre formatos y metadatos compartidos. En este caso, Teradata accede a OneLake mediante las API de Iceberg, una decisión que alinea la integración con un estándar ampliamente adoptado en ecosistemas de lakehouse.
La identidad y el control de acceso completan la arquitectura. El anuncio cita autenticación y controles nativos entre plataformas, con Microsoft Entra ID como componente de identidad. Para una empresa, esta característica puede simplificar la aplicación de permisos y la incorporación del acceso a sus procesos existentes de seguridad. También facilita que los equipos de datos trabajen con identidades corporativas reconocibles, sujetas a las políticas definidas por la organización.
La interoperabilidad técnica exige conservar una visión completa del gobierno. Los responsables deberán revisar permisos, registro de actividad, clasificación, residencia, costes de consulta y responsabilidades operativas. El acceso de lectura disponible establece un alcance inicial concreto: análisis y consumo de datos de OneLake desde Teradata. Las decisiones sobre actualización, escritura o sincronización requieren capacidades confirmadas y un diseño adicional cuando el caso de uso las necesite.
Qué cambia para los proyectos empresariales de datos
El anuncio responde a un problema habitual en las plataformas corporativas: cada copia añade almacenamiento, procesos de actualización, controles de seguridad y riesgo de divergencia. Consultar los datos donde residen puede reducir ese trabajo y acelerar la puesta en marcha de productos analíticos. El ahorro potencial debe medirse en cada organización, porque intervienen el patrón de consultas, el volumen, la red, la concurrencia y las condiciones comerciales de ambas plataformas.
Para los equipos de inteligencia artificial, el soporte de pipelines de características permite preparar variables a partir de datos distribuidos entre OneLake y Teradata. El soporte de joins complejos amplía las opciones para construir vistas enriquecidas, mientras que las consultas tácticas con SLA apuntan a escenarios vinculados a decisiones operativas. Entre los candidatos figuran personalización, detección de anomalías, previsión de demanda y priorización comercial, siempre sujetos a validación técnica, calidad de datos y gobierno del modelo.
La adopción puede empezar con un inventario de conjuntos de datos, permisos y cargas que hoy dependen de copias. A partir de ahí, una prueba controlada debería comparar tiempos de preparación, rendimiento, costes y trazabilidad frente al flujo actual. También conviene separar los casos de lectura analítica de aquellos que requieren escritura, ya que el comunicado confirma disponibilidad para el primer grupo.
Teradata mostrará la integración durante la European Microsoft Fabric + SQL Community Conference, prevista en Barcelona del 28 de septiembre al 1 de octubre de 2026. La demostración ofrecerá una ocasión para observar el funcionamiento entre plataformas y aclarar aspectos de despliegue. Para las empresas, el interés principal reside en comprobar hasta qué punto el acceso in situ simplifica su arquitectura manteniendo rendimiento, seguridad y control.
Fuentes
Comunicado de Teradata: Teradata Brings Enterprise AI Directly to Microsoft OneLake