Microsoft presentó el 12 de octubre de 2026 Maia 300, la próxima generación de su plataforma propia para ejecutar modelos de inteligencia artificial. La compañía prevé iniciar los despliegues de producción en 2027 y ampliar la familia Azure Maia hasta instalaciones de varios gigavatios. Su objetivo declarado es convertir este sistema en la infraestructura principal de inferencia para productos como Microsoft Copilot, GitHub, Microsoft Foundry, Teams y Dragon Copilot.
El anuncio llega cuando el crecimiento de los asistentes y agentes empresariales está elevando el consumo eléctrico, la demanda de memoria y el coste de servir cada respuesta. Microsoft plantea Maia 300 como un sistema completo diseñado alrededor de sus cargas reales, con especial atención al razonamiento con contextos largos, las conversaciones sensibles a la latencia y los procesos de agentes que mantienen actividad durante varios pasos. La estrategia combina silicio, memoria, red, compiladores y aplicaciones en una misma arquitectura.
Maia 200, la generación actualmente en producción, ya procesa cargas de Microsoft Copilot y ayuda al equipo MAI a desarrollar nuevos modelos. También está previsto que se incorpore a GitHub Copilot y Microsoft Foundry antes de terminar 2026. Esta base permite a Microsoft observar el comportamiento de modelos propios, modelos de OpenAI y familias abiertas a gran escala, y utilizar esos datos operativos para diseñar la siguiente generación.
Más inferencia dentro del mismo límite energético
Microsoft espera que Maia 300 produzca un 40 % más de tokens por megavatio que los sistemas basados en GPU que utiliza como referencia. En una configuración completa de 96 aceleradores, la empresa proyecta hasta siete veces el rendimiento de tokens por rack de Maia 200. Ambas cifras son estimaciones del fabricante para una plataforma que todavía debe entrar en producción, por lo que tendrán que contrastarse con cargas, modelos y niveles de servicio reales.
La métrica energética tiene una relevancia directa para los centros de datos. El suministro eléctrico, la refrigeración y la capacidad de red condicionan dónde puede ampliarse una plataforma de IA y cuánto cuesta atender cada consulta. Un aumento sostenido del rendimiento por megavatio permitiría procesar más peticiones dentro de una instalación existente o reservar capacidad para modelos con contextos más amplios. El efecto final dependerá también de la utilización, el software, la disponibilidad del hardware y la complejidad de cada modelo.
Microsoft afirma que Maia 200 ya ofrece hasta 1,7 veces más tokens por vatio para funciones integradas en Teams, Copilot y Cowork frente a infraestructuras GPU de referencia. La compañía está desplegando esta generación en Estados Unidos, Europa y Australia. Maia 300 amplía esa dirección con un diseño orientado a la inferencia y con una escala eléctrica que revela la magnitud prevista para el consumo de IA dentro de los servicios de Microsoft.
Una arquitectura diseñada para contexto, memoria y agentes
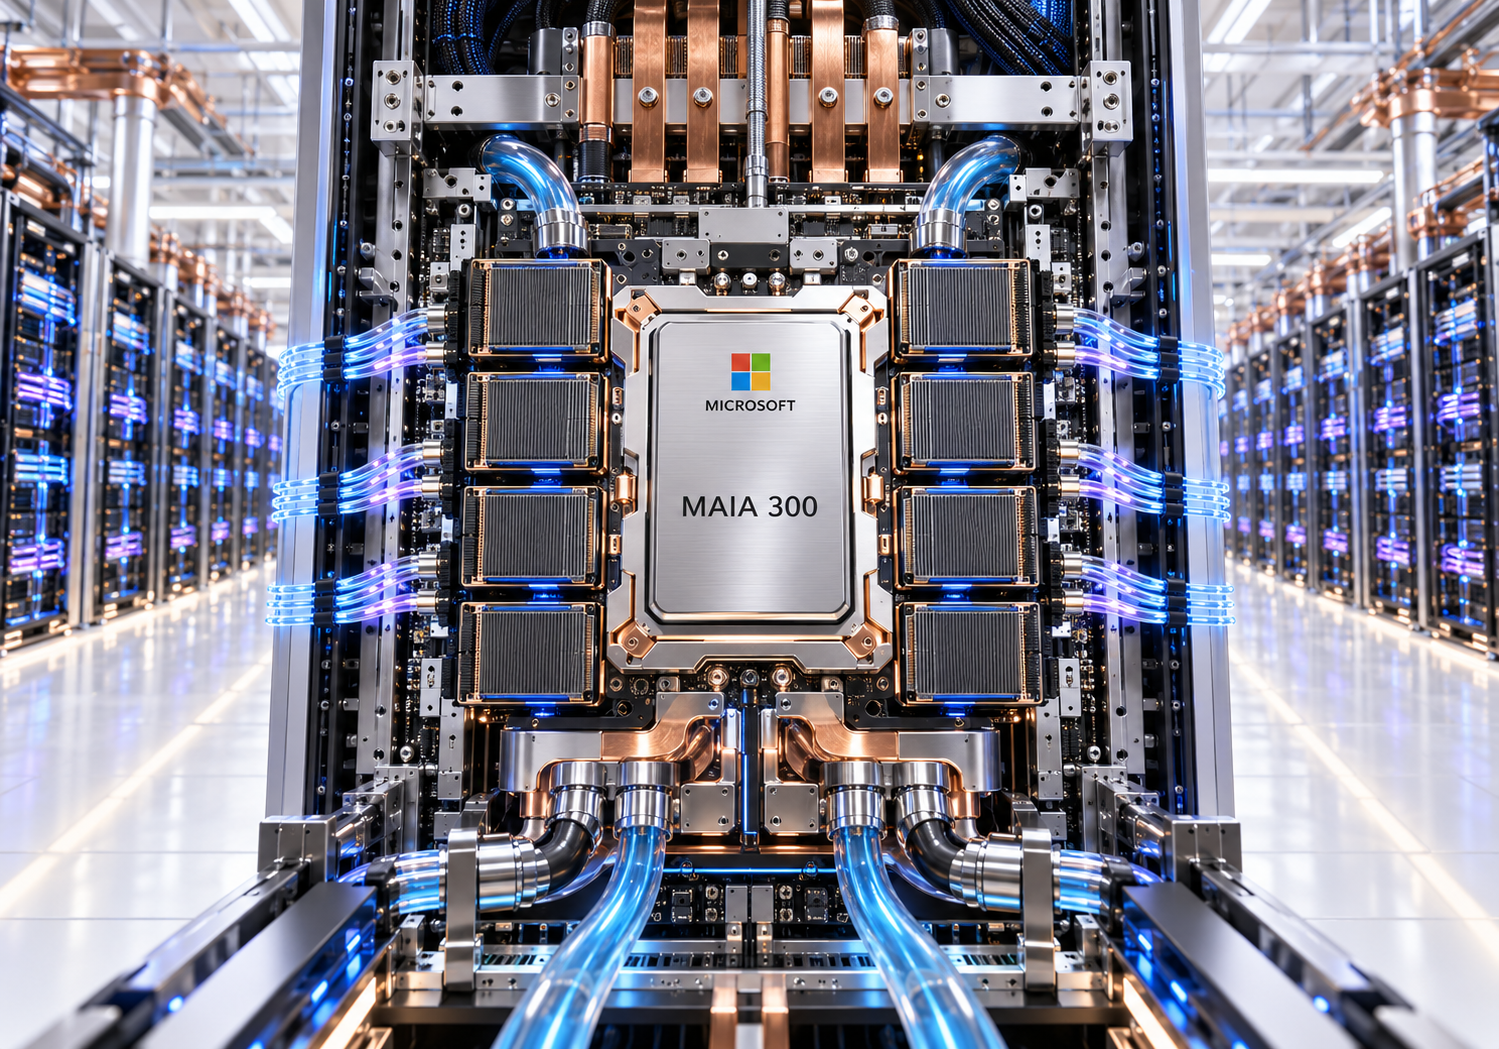
Maia 300 utilizará ocho pilas de memoria HBM4, con un ancho de banda máximo anunciado de 18 TB/s y un consumo térmico de diseño de 950 vatios. La arquitectura separa las funciones de cálculo, control de memoria y entrada y salida mediante varios chiplets. Los chiplets de cálculo se fabricarán con el proceso N2P de TSMC. Microsoft también incorpora formatos de baja precisión, incluido MXFP4 mejorado, para reducir las necesidades de memoria y ancho de banda durante la ejecución.
El movimiento de datos se convierte aquí en una prioridad de diseño. Los modelos de gran tamaño dedican una parte considerable de sus recursos a trasladar pesos, estados y cachés entre memoria y unidades de cálculo. Microsoft combina un flujo de datos definido por software con optimización de kernels asistida por IA para aumentar la localidad y mantener ocupados los componentes del sistema. La memoria SRAM integrada funciona como espacio de trabajo gestionado por software y reduce la presión sobre HBM.
La red de interconexión también forma parte del sistema. Un rack con decenas de aceleradores necesita compartir información con baja latencia para comportarse como una unidad de inferencia. Esta coordinación resulta especialmente importante en tareas con contexto prolongado y en agentes que encadenan llamadas, herramientas y verificaciones. La experiencia del usuario depende del tiempo total de respuesta, mientras que el proveedor debe controlar el consumo y la capacidad utilizada durante todo el proceso.
Qué cambia para las empresas que consumen IA en la nube
La mayoría de las organizaciones accederá a Maia de forma indirecta, a través de servicios de Microsoft. El valor empresarial aparecerá en el precio, la latencia, la capacidad disponible y las funciones que puedan sostener productos como Copilot, Foundry o GitHub. Una plataforma propia concede a Microsoft mayor control sobre la evolución conjunta de modelos, software e infraestructura y amplía sus opciones frente a la oferta de aceleradores externos.
Ese control vertical introduce nuevas cuestiones de evaluación. Las empresas necesitarán conocer qué regiones, modelos y servicios utilizan Maia; qué compromisos de rendimiento y disponibilidad ofrece cada producto; y cómo se trasladan las mejoras energéticas al coste facturado. También será importante medir los resultados en procesos completos. Un agente puede generar tokens con eficiencia y, al mismo tiempo, consumir muchas llamadas si el flujo incluye búsquedas, reintentos, comprobaciones o conexiones con varias aplicaciones.
El anuncio marca además una evolución en la compra de tecnología cloud. La comparación entre plataformas de IA incorporará cada vez más variables de infraestructura: rendimiento por vatio, ancho de banda de memoria, capacidad regional, compatibilidad de modelos, observabilidad y portabilidad. Para los equipos de arquitectura, Maia 300 representa una señal clara: la eficiencia del silicio y la integración del sistema influirán directamente en la viabilidad económica de los agentes empresariales a gran escala.