TypeSafe AI salió de su etapa de desarrollo reservado a mediados de septiembre con Jev, un modelo diseñado para decidir dentro del software en lugar de conversar con una persona. La compañía, fundada en 2024 por el antiguo investigador de OpenAI Diogo Almeida junto a Erik Gafni y Sasha Sheng, anunció además una ronda semilla de 40 millones de dólares liderada por DCVC. Su primera apuesta pública cuestiona una práctica extendida: utilizar grandes modelos de lenguaje para tareas que terminan reducidas a una clasificación, una puntuación o una elección entre rutas conocidas.
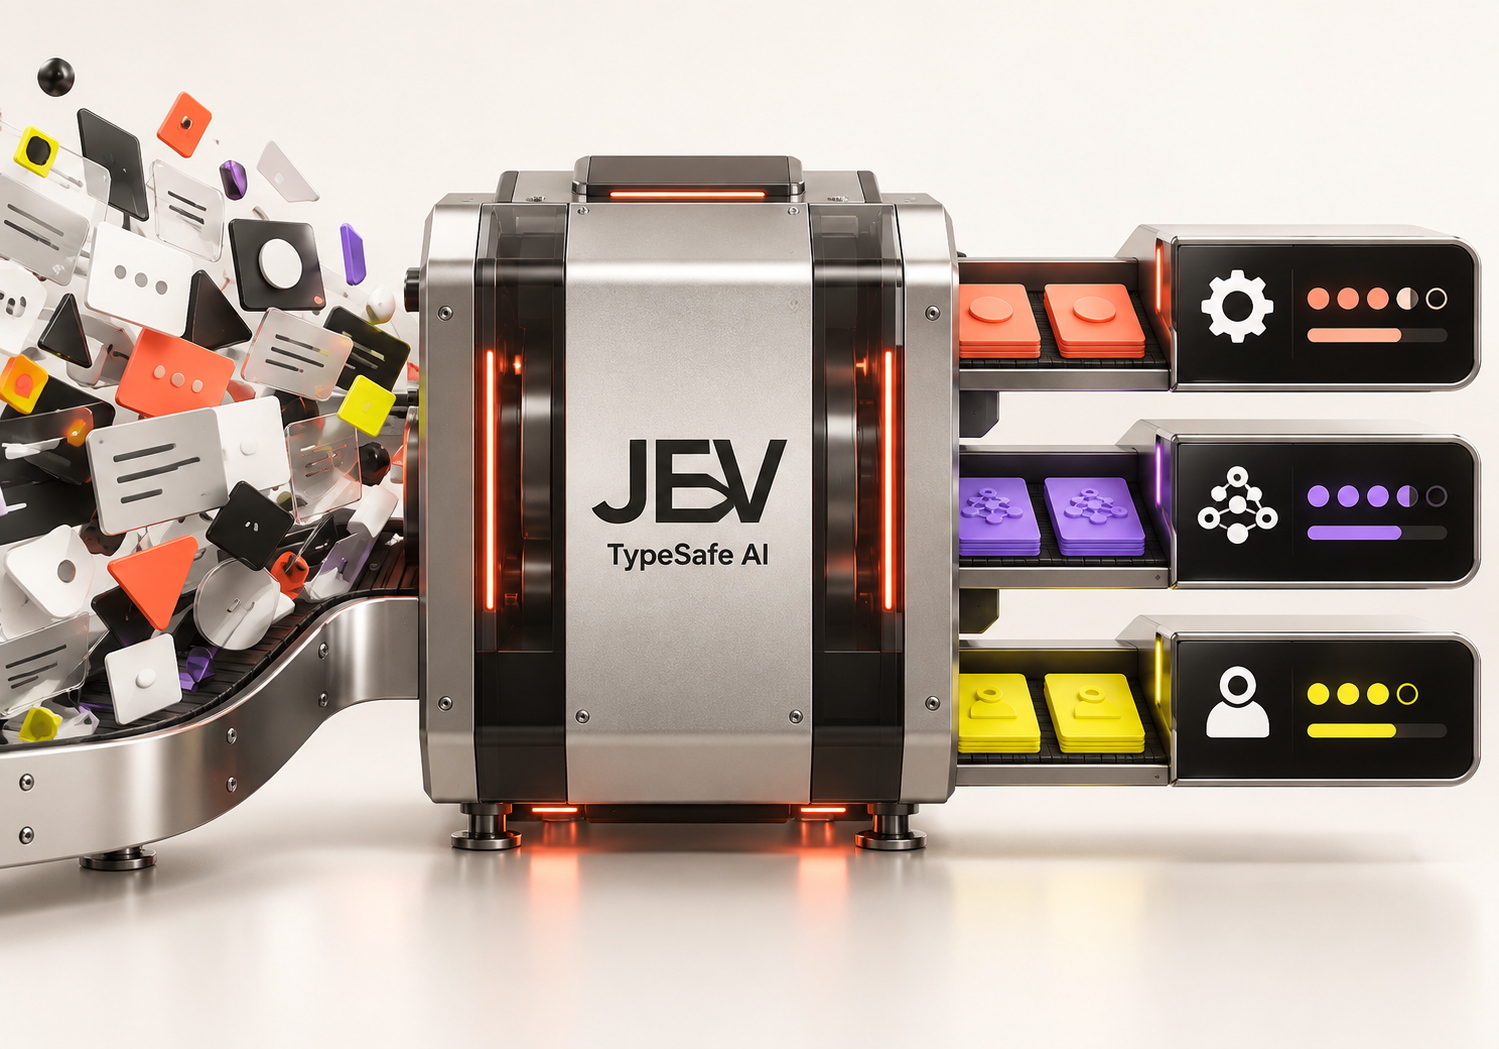
Jev recibe un estado con información del caso, evalúa varias preguntas y devuelve valores tipados con probabilidades. Puede decidir a qué equipo corresponde una incidencia, estimar su urgencia, identificar una categoría documental o señalar si una acción de un agente requiere revisión. La aplicación conserva las reglas, los umbrales y la ejecución. TypeSafe denomina a esta categoría System One Models, en referencia al pensamiento rápido popularizado por Daniel Kahneman.
El lanzamiento llega acompañado de cifras llamativas: entre 70 y 500 milisegundos de latencia, un precio de 0,042 dólares por millón de tokens de entrada y salida gratuita. La propia empresa reconoce que sus multiplicadores máximos de velocidad y coste proceden de evaluaciones internas y probablemente representan la parte alta de las mejoras reales. Jev está documentado como API operativa y continúa descrito oficialmente como acceso temprano, sin disponibilidad de pesos ni ejecución local.
Una interfaz de decisiones para el software
La API de Jev parte de un state, expresado como texto, JSON o una colección de valores textuales. El desarrollador añade preguntas cuyas respuestas posibles están definidas de antemano. El modelo actual, Jev 1.13, ofrece tres primitivas: Choice selecciona entre alternativas y devuelve su distribución de probabilidad; Score sitúa el caso en una rúbrica de dos a diez niveles; y Noul calcula entre cero y uno la probabilidad de una condición binaria.
Varias preguntas sobre el mismo estado se procesan en paralelo. Un sistema de atención puede evaluar en una llamada el área responsable, la urgencia, la posible duplicidad de un cobro y la necesidad de escalar el caso. Después, el código aplica comprobaciones deterministas y decide si continúa, consulta un modelo generativo o solicita intervención humana. Esta separación ofrece una arquitectura útil para procesos con taxonomías estables y grandes volúmenes de decisiones repetitivas.
TypeSafe atribuye este comportamiento a un muestreador paralelo y a un método de entrenamiento denominado Reinforcement Learning for Calibrated Decisions (RLCD). La calibración pretende que una probabilidad de 0,9 corresponda, dentro de grupos comparables, a una frecuencia de acierto próxima al 90 %. La documentación introduce una cautela decisiva: esa propiedad se mide sobre conjuntos de predicciones y no garantiza que una respuesta individual sea correcta.
La salida ajustada al esquema impide que Jev invente campos o entregue un tipo incompatible. Ese es el alcance técnico de la expresión comercial «cero alucinaciones». El modelo todavía puede elegir una opción válida y equivocada, incluso con una confianza alta. En términos empresariales, elimina errores de formato y respuestas fuera del contrato; el riesgo semántico permanece y debe medirse sobre datos reales.
Velocidad y coste con resultados desiguales
TypeSafe publica un contexto máximo de 64.000 tokens por petición y un límite adicional de 32.000 para el estado más la pregunta de mayor tamaño. El precio anunciado equivale a 42 dólares por cada mil millones de tokens de entrada. La compañía asegura que sus pruebas internas alcanzan ventajas de hasta 193,6 veces en velocidad y 444,6 veces en coste frente a modelos de frontera. Sus cuatro flujos fueron construidos por el propio equipo y utilizaron como referencia el promedio de las respuestas de dos modelos avanzados, en vez de una verdad de terreno independiente.
Las primeras evaluaciones externas dibujan un resultado más matizado. LangChain utilizó Jev para juzgar cinco trazas de un agente meteorológico, repetidas cien veces. El modelo coincidió con la revisión humana en las 500 decisiones binarias, registró una media de 0,44 segundos y redujo de forma notable el coste y la variabilidad. La muestra contenía únicamente cinco casos distintos, por lo que mide principalmente consistencia sobre un escenario estrecho.
Un benchmark reproducible con 2.000 correos de phishing encontró el equilibrio contrario. Jev 1.13 obtuvo un 62,6 % de exactitud frente al 81,3 % de Claude Haiku 4.5. A cambio, su mediana fue de 239 milisegundos frente a 687 y su coste estimado resultó doce veces menor. La descomposición del problema en cinco señales y una regresión logística elevó el resultado hasta aproximadamente el 95 %, aunque añadió diseño de preguntas, datos etiquetados y un clasificador que la empresa usuaria tendría que mantener.
Otra prueba sobre 108 afirmaciones vinculadas a sus documentos fuente situó a Jev en el 96,3 %, ligeramente por encima de Gemini 3.1 Flash Lite y Claude Haiku 4.5. Los tres ofrecieron errores de calibración muy similares. Ambos trabajos apuntan a una conclusión práctica: Jev puede destacar cuando el juicio está bien delimitado, pero la precisión depende de la tarea, del contexto suministrado y de cómo se construyan las preguntas.
Qué debe comprobar una empresa antes de desplegarlo
El modelo encaja en enrutamiento de solicitudes, clasificación documental, priorización de incidencias, filtrado de resultados, evaluación de trazas y controles previos a llamadas de herramientas. También puede funcionar como primera capa de una arquitectura escalonada: automatizar casos de confianza alta, derivar los dudosos a un LLM y reservar las decisiones sensibles para una persona.
TypeSafe publica una lista poco habitual de limitaciones. Jev 1.13 interpreta las instrucciones de forma literal, cuenta con poca fiabilidad, trata las fechas como texto y pierde precisión cuando el estado acumula información irrelevante. Tampoco considera hostil el contenido de entrada por defecto, de modo que una inyección puede alterar la respuesta. El inglés ofrece actualmente el mejor rendimiento; otros idiomas requieren validación específica. La aritmética, las comparaciones temporales y las reglas exactas pertenecen al código, mientras las tareas de investigación, planificación, explicación o redacción requieren modelos generativos.
Un piloto empresarial debería medir exactitud por clase, falsos positivos y negativos, calibración, cobertura a distintos umbrales, robustez ante cambios de formato y coste completo del proceso. Ese cálculo debe incorporar preprocesamiento, observabilidad, reintentos, revisiones humanas y llamadas al sistema de respaldo. Conviene fijar la versión jev-1.13.0 cuando se ajusten los umbrales, porque el alias jev-latest puede cambiar y modificar las decisiones sin una actualización de la aplicación.
Quedan preguntas estructurales abiertas. TypeSafe no ha publicado un artículo científico sobre RLCD, el número de parámetros, el diseño de capas, los datos sintéticos detallados, el cómputo de entrenamiento ni los pesos. Tampoco existe todavía una auditoría externa amplia que pruebe la sostenibilidad del precio o una ventaja general de calibración. Jev presenta una especialización relevante para convertir juicio probabilístico en una pieza de software. Su valor dependerá de mantener precisión bajo tráfico real y de permitir que cada error se detecte, se explique operativamente y se corrija dentro del proceso.
Fuentes
- TypeSafe AI: Introducing System One Models and Jev.
- Business Wire: TypeSafe AI emerge del modo stealth con 40 millones de dólares.
- TypeSafe AI: documentación de System One.
- TypeSafe AI: modelos, precios y límites.
- TypeSafe AI: limitaciones conocidas de Jev 1.13.
- LangChain: evaluación de Jev como juez de agentes.
- Benchmark reproducible de Jev sobre 2.000 correos de phishing.
- TrueStandard: evaluación de Jev sobre 108 afirmaciones.